iPAS AI 產業工程師認證專題解析

AI 模型訓練與應用架構

FROM RAW DATA TO INTELLIGENCE: PIPELINE DEEP DIVE
#數據清洗 #模型選擇 #激活函數 #優化器AdamW #LoRA微調 #RAG向量檢索
主講/製作:奕鈞老師
•
官方網站:ijun-ai.com
•
快捷鍵:[← / →] 切換 [F] 全螢幕 [M] 目錄
PIPELINE OVERVIEW

端到端 AI 模型訓練與部署全景架構

端到端流程 模型核心 應用落地
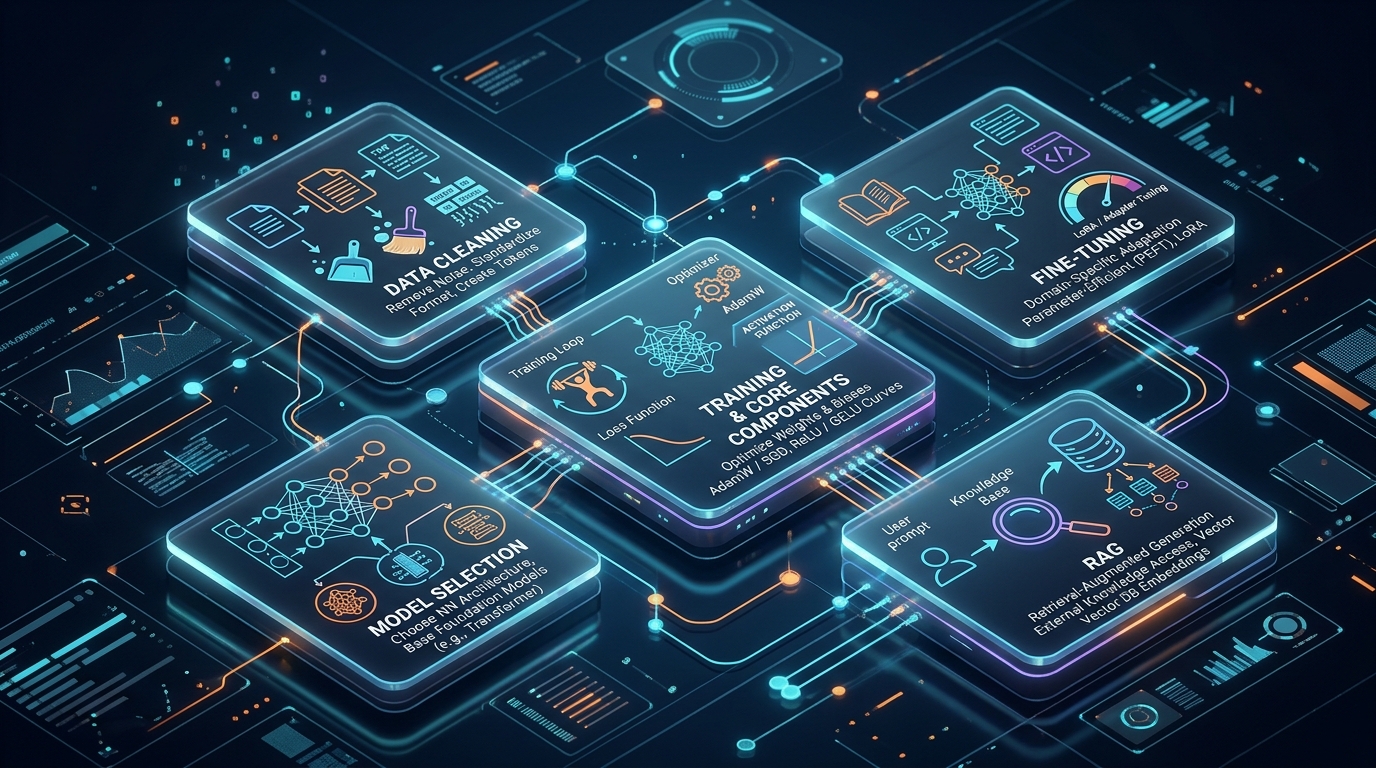
AI 模型訓練與優化全流程架構圖
AI MODEL TRAINING & RETRIEVAL PIPELINE
STEP 01 FOUNDATION DATA PIPELINE
CORE METHODOLOGIES
01.1
噪聲過濾與脫敏
清除 HTML 雜訊代碼、排版亂碼、無意義符號,並進行 PII(個人隱私資料)脫敏 與有害內容(Toxicity)安全性篩檢。
01.2
語意去重 (Deduplication)
採用 MinHash 或 SimHash 進行大量網頁語料的模糊去重,防止模型過度擬合特定樣板,顯著降低記憶冗餘。
01.3
格式標準化與過濾
統一字元編碼(UTF-8),剔除過短、過長或重複率異常段落,過濾低質量或語意不連貫的機器生成廢料。
01.4
分詞器 (Tokenization)
利用 Byte-Pair Encoding (BPE) 或 SentencePiece 將自然語言轉為整數 Token ID,建立高效詞表(Vocabulary)。
💡 認證核心考點: 分詞器(Tokenizer)不具備神經網路權重,是一套確定的規則對照字典;分詞效率直接影響模型吞吐量與多語言理解能力。
STEP 02 NEURAL NETWORK TOPOLOGY
ARCHITECTURAL TAXONOMY
02.1
Decoder-Only 架構
現代大模型(LLM)主流(如 GPT-4、LLaMA、DeepSeek)。專精自回歸文字生成,利用因果自注意力機制預測下一個 Token。
02.2
Encoder-Decoder 架構
經典代表為 T5、BART。適合文本摘要、跨語言機器翻譯等輸入輸出長度差異顯著的序列轉換任務。
02.3
參數量級抉擇 (Scale)
- 端側小模型(1B-3B):適合手機與邊緣運算。
- 中型主力(7B-14B):性價比最高,單卡可推論。
- 旗艦大模型(70B+ / MoE):複雜推理與多輪推理。
02.4
長上下文支援 (Context)
引入 RoPE(旋轉位置編碼)、FlashAttention 與動態外推技術,支援 32K~1M+ Tokens 超長文檔檢索與深度解析。
💡 認證核心考點: Transformer 的核心核心是「自我注意力機制(Self-Attention)」,其計算複雜度與序列長度成平方級關係($O(N^2)$)。
STEP 03 MATHEMATICAL NON-LINEARITY
ACTIVATION FUNCTION EVOLUTION
03.1
Sigmoid / Tanh (早期)
將輸出壓縮至 (0, 1) 或 (-1, 1)。缺點是在兩端飽和區會產生嚴重的 梯度消失(Vanishing Gradient),深層網路無法有效傳播更新。
03.2
ReLU (奠定現代深度學習)
$f(x) = \max(0, x)$。計算極其高效,正半軸無梯度飽和,大幅緩解梯度消失問題;但負半軸可能導致神經元永久失活(Dying ReLU)。
03.3
GELU (Gaussian Error)
BERT、GPT 標配。將正態分佈概率結合到輸入中,具有平滑可導的特性,在非線性臨界點表現出更自然的梯度傳遞。
03.4
SwiGLU (新一代大模型標配)
LLaMA、Mistral 廣泛採用。結合門控機制(GLU)與 Swish 函數,經驗證明相較標準 ReLU/GELU 具有更優異的收斂速度與表現力。
💡 認證核心考點: 激活函數主要任務是引入「非線性能力」;現代 LLM 優先選擇平滑且具門控特性的激活函數(GELU、SwiGLU)。
STEP 04 GRADIENT UPDATE ALGORITHMS
OPTIMIZER MECHANISMS
04.1
SGD 與 Momentum (動量)
隨機梯度下降每次只使用批次(Mini-batch)數據更新。加入 動量(Momentum) 模擬物理慣性,能衝出鞍點並抑制局部震盪。
04.2
自適應學習率:Adam
結合了一階動量(梯度均值)與二階動量(梯度方差未中心化),為每個參數獨立調整步長,對稀疏特徵非常友好。
04.3
當前工業標配:AdamW
修正了原版 Adam 將 L2 正則化與權重衰減(Weight Decay)混淆 的數學瑕疵,大幅改善模型的泛化能力與大模型訓練穩定度。
04.4
學習率排程 (Scheduler)
配合 Warm-up(熱身階段) 與 餘弦退火(Cosine Decay),前期避免發散破壞隨機權重,後期精細尋優防止跳出最優谷底。
💡 認證核心考點: 為什麼大模型預訓練首選 AdamW?因為它將 Weight Decay 從梯度更新中解耦,真正達成正確的權重收斂懲罰!
STEP 05 DOWNSTREAM ADAPTATION
FINE-TUNING PARADIGMS
05.1
全參微調 (Full FT)
更新模型中 100% 的參數。優點是擬合上限高,但缺點是需要高達 4~6 倍的 GPU 記憶體儲存梯度與優化器狀態,且易發生 災難性遺忘。
05.2
指令微調 (SFT)
使用精心標註的「使用者 Prompt + 完美回答」多輪對話數據集,讓模型學會對齊人類提問意圖、語氣規範與思維鏈(CoT)。
05.3
參數高效微調 (LoRA)
Low-Rank Adaptation:凍結原模型權重 $W$,僅外掛低秩分解矩陣 $\Delta W = A \times B$($r \ll d$)。訓練參數量少於 1%,節省 80% 算力!
05.4
QLoRA (極致輕量化)
將基礎模型量化至 4-bit NormalFloat (NF4),搭配雙重量化與分頁優化器,讓單張消費級顯示卡(如 RTX 4090)即可微調 70B 模型。
💡 認證核心考點: LoRA 的本質是「低秩分解」;推論時可以將權重矩陣直接加回基礎模型中,完全不會增加推論延遲!
STEP 06 DYNAMIC KNOWLEDGE INGESTION
RAG THREE-STAGE PIPELINE
06.1
文件切分與向量化
將企業文檔切割為具語意完整性的 Chunks,經由 Embedding 模型 轉化為高維稠密向量,存入向量資料庫(如 Milvus, Pinecone, Chroma)。
06.2
相似度語意檢索 (Retrieve)
用戶提問即時向量化,透過 餘弦相似度(Cosine) 或 HNSW 索引 快速檢索出語意最相關的 Top-K 文本片段。
06.3
上下文增強 (Augment)
系統將檢索出的片段作為「背景參考依據(Context)」動態拼入 Prompt,並給出「僅能依據上述資料回答」的嚴格防幻覺約束。
06.4
精準溯源生成 (Generate)
大模型基於所附資料組織答案,並附帶原文引用出處(Citations),大幅提高醫療、法律、金融等專業領域的回答可信度。
💡 認證核心考點: RAG 核心優勢在於「知識實時更新」且「無須重新耗費算力訓練神經網路」;但檢索品質受限於切分粒度與向量相似度演算法。
SUMMARY ARCHITECTURE COMPARISON MATRIX
DECISION MATRIX
比較維度 模型微調 (Fine-Tuning) 檢索增強生成 (RAG)
主要目的 改變模型行為、風格、特定輸出格式(如 JSON) 提供即時、精準、動態更新的私有資料與領域事實
知識更新頻率 靜態。知識庫若有異動需重新訓練或追加微調 即時動態。向量資料庫可隨時新增/刪除文件
幻覺抑制 有限,模型仍可能憑想像自信胡謅 極佳,強迫模型引用檢索出的依據並附帶出處
算力與維運成本 高(需 GPU 叢集、調參經驗與優化算力) 低~中(只需 Embedding 與向量資料庫伺服器)
企業最佳實踐 🚀 雙軌合一:用 LoRA 微調 定制專屬領域術語與輸出規範,搭配 RAG 掛載最新公司資料庫!
SUMMARY & ROADMAP

掌握 AI 訓練與落地全流程

DATA PREPARATION → ARCHITECTURE → TRAINING LOOP → ADAPTATION → GROUNDING
從嚴格的數據清洗出發,歷經最優架構選擇、激活函數與 AdamW 優化器的高效收斂,
再到 LoRA 微調賦能與 RAG 精準溯源,方能建構出兼具智慧、準確與商業價值的現代 AI 系統。
奕鈞老師數位教學備課室 • iPAS AI 認證考前研析
專屬網站:https://www.ijun-ai.com/
01 / 10
PRESENTATION OUTLINE