iPAS AI 初級考試方向分析
與核心重點速成筆記
1. 官方學習指引重點整理,快速畫記
iPAS AI 初級認證旨在檢定學員是否具備「AI 基礎通識知識」與「生成式 AI 工具應用及合規落地能力」。考試由兩大科目構成,單科皆須達 70 分及格。
📘 科目一:人工智慧概論與機器學習基礎
- AI 發展歷史與典範轉移:符號主義(規則)➔ 連接主義(類神經網絡)➔ 統計機器學習 ➔ 深度學習 ➔ 基礎大模型(Foundation Models)。
- 機器學習三大類別:
• 監督式學習(有標籤,分類與迴歸)
• 非監督式學習(無標籤,K-Means 分群、PCA 降維)
• 強化學習(獎勵回饋,RLHF 人類反饋強化學習) - 模型評估指標:混淆矩陣、準確率(Accuracy)、精確率(Precision)、召回率(Recall)、F1-Score、ROC-AUC 曲線應用情境。
💡 科目二:生成式 AI 應用與實務規範
- 生成式 AI 核心技術:Transformer 架構、自注意力機制(Self-Attention)、擴散模型(Diffusion Models)、生成對抗網絡(GAN)。
- 提示工程(Prompt Engineering):Zero-shot、Few-shot、思維鏈(CoT: Chain-of-Thought)、ReAct 框架。
- 落地防護與倫理法規:幻覺(Hallucination)抑制、RAG 向量檢索架構、數據偏見、著作權歸屬、個人資料保護法與歐盟 AI 法案(EU AI Act)風險分級。
「見標籤選監督,見分群選非監督;查醫療罕病看召回率(Recall 高),評垃圾郵件看精確率(Precision 高);LLM 防幻覺外掛 RAG,改行為語氣用 LoRA 微調。」
2. 學習地圖重點解析(訓練至落地管線)
貫穿 iPAS 考綱的靈魂主線——大語言模型從無到有的完整生命週期:數據清洗 ➔ 模型選擇 ➔ 核心訓練(激活函數與優化器)➔ 微調適應 ➔ RAG 外掛檢索。
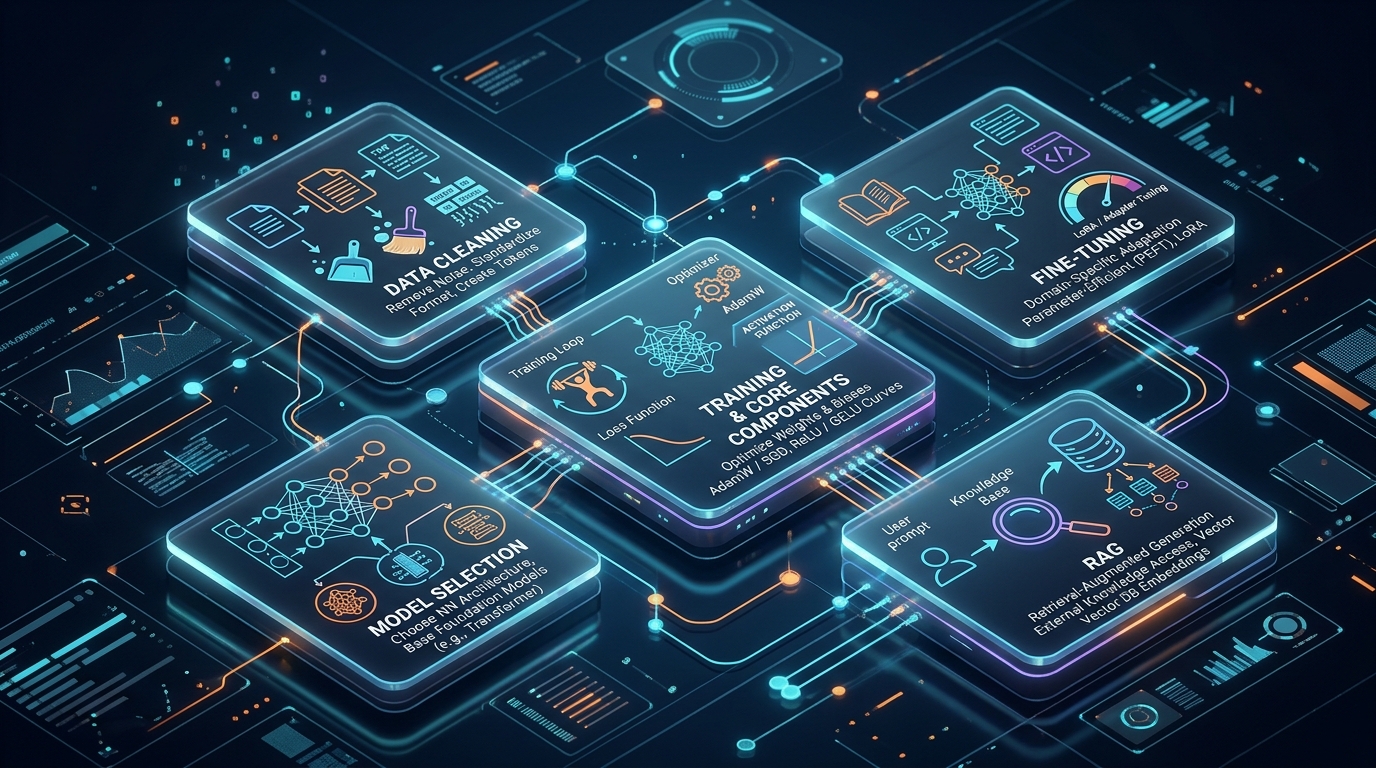
FIGURE: END-TO-END AI MODEL TRAINING & INFERENCE PIPELINE
🧹 數據清洗與模型選擇
數據清洗:去噪、MinHash 語意去重、Tokenization(BPE 算法)。品質決定模型能力上限(Garbage In, Garbage Out)。
模型選擇:現代大模型普遍採用 Decoder-Only Transformer(因果自注意力),依推論硬體資源權衡參數量級(1B~70B)。
⚙️ 激活函數與優化器 (訓練核心)
激活函數:賦予網絡「非線性擬合能力」。從早期的 ReLU 邁向現代大模型主流的 GELU 與具門控機制的 SwiGLU。
優化器:工業標準首選 AdamW,解耦了 L2 正則化與 Weight Decay,讓權重更新穩定不發散。
🎯 模型微調 (Fine-Tuning)
指令微調 (SFT):教導 Base Model 遵循人類指示對話。
PEFT / LoRA:凍結原權重,僅外掛低秩分解矩陣(Low-Rank Adaptation),訓練參數少於 1%,推論延遲為零!
🔍 檢索增強生成 (RAG)
外掛專屬知識庫:將企業文件切分、Embedding 向量化並存入向量資料庫(Vector DB)。
抗幻覺與溯源:用戶提問即時檢索 Top-K 依據注入 Prompt,強迫模型附註出處回答,終結模型胡謅問題。
3. 免費題庫:考古題 + 模擬試題
刷題是檢驗實力的最快途徑!本研習已為大家整理了完整的考古題庫與線上測驗工具,包含歷屆試題與高擬真模擬題。
🔥 必練考點一:常見混淆陷阱題
- Q:在訓練深度學習模型時,若發現訓練集 Loss 很低,但驗證集 Loss 很高,此現象稱為什麼?該如何解決?
- 解析:此為標準 過擬合(Overfitting)。解決方案包含:加入 Dropout、L2 權重衰減(Weight Decay)、資料增強(Data Augmentation)或提前終止訓練(Early Stopping)。
🔥 必練考點二:提示詞與 RAG 機制題
- Q:企業想要讓內部客服機器人精準回答最新的退換貨政策,且不可洩露其他員工薪資,最合適的架構是什麼?
- 解析:採用 RAG(檢索增強生成) 搭配權限控管的向量資料庫,既不用重新訓練模型,又能保證資訊即時性與數據邊界隔離。
4. 自製講義提示詞(AI 考前極速生講義 Prompt)
想要自己針對弱點章節產出客製化講義?複製以下奕鈞老師專屬設計的「考前衝刺講義生成 Prompt」,貼到 Gemini 或 ChatGPT 即可自動產生結構化衝刺講義:
5. 今年三次考古題解析(出題脈絡與趨勢透析)
綜觀 115 年第 1、2、3 次考試真題,題目已從傳統的「死記名詞定義」全面轉向「場景落地與技術架構選型」:
📌 趨勢一:大模型微調與推論成本計算
考題不再只問什麼是微調,而是給出硬體限制(例如:只有一張 24GB VRAM 的 RTX 4090),詢問微調 70B 模型該選用哪種技術?
✔ 正解方向:選擇 QLoRA(4-bit 量化 + LoRA),全參微調絕對會 OOM 爆顯存。
📌 趨勢二:RAG 與向量資料庫相似度演算法
題目出現餘弦相似度(Cosine Similarity)、歐幾里得距離(L2)與內積(Dot Product)的差異,並考問為何高維 Embedding 普遍採用餘弦相似度?
✔ 正解方向:因為餘弦相似度關注向量間的「角度(方向)」,不受文本長度造成的向量模長膨脹干擾。
📌 趨勢三:生成式 AI 法律、版權與合規
考題頻繁出現「AI 生成內容能否申請著作權法保護?」以及「利用有版權作品進行模型訓練是否構成合理使用?」。
✔ 正解方向:純 AI 生成物無人類精神創作,目前不享有著作權;模型訓練時若符合合理使用標準可能免責,但生成具體相似侵權物仍受追究。
📌 趨勢四:優化器與激活函數的演進
今年三次考題皆出現了 AdamW 與 GELU / SwiGLU 的身影,考驗考生是否具備現代大模型技術棧常識。
✔ 正解方向:理解 AdamW 對 Weight Decay 的修正,以及 GELU 引入高斯誤差正態分佈的平滑特性。
🖥️ 互動投影片播放展示
支援鍵盤 [← / →] 切換、[F] 全螢幕模式、[M] 目錄跳轉,亦支援手機觸控滑動: